

输入一段提示词,几分钟甚至更短时间后,一段原本只存在于想象中的视频便出现在屏幕上,如宇航员在月球骑自行车、小猫穿着雨衣逛夜市、古城在晨雾中苏醒等。生成式人工智能(Generative AI,简称GenAI)正在降低影像创作的门槛。然而,当“一键生成视频”成为现实,新的问题也随之而来:这些GenA生成的视频质量究竟如何,该由谁来评价打分?人工评价难免带有主观偏好,且不同的人关注的侧重点也各不相同。因此,为了更加全面、客观地评价GenAI生成视频的质量,一套融合人类主观感受、视觉感知规律与人工智能技术的质量评价体系应运而生。它如同生产线上的“智能质检员”,虽然不参与视频创作,却能从单帧画面细节和连续动态变化中识别异常,为生成模型改进、平台内容筛选及用户素材选择提供参考。
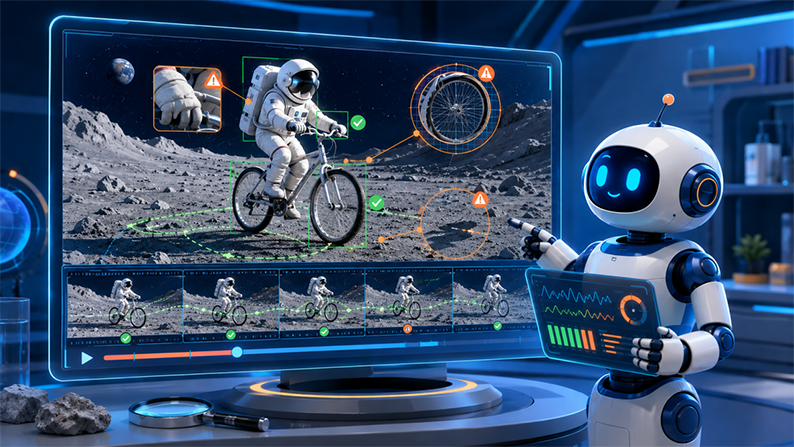
图1 “智能质检员”对GenAI生成的视频进行检测
一、画面够清楚,就等于质量好吗?
以一段GenAI生成的视频“宇航员在月球骑自行车”为例,其视频分辨率很高,宇航服的纹理清晰可见,但播放几秒后,奇怪的现象就出现了——车轮扭曲变形、宇航员的手指忽多忽少、地面影子朝向不符合物理规律等。这样的视频无论有多清晰,都不能算作高质量作品。普通视频常见的问题,如画面模糊、噪点过多、播放卡顿、色彩失真,多来自拍摄、压缩或传输过程。而GenAI生成视频还会出现一类独有的错误,即它没有真实摄像机记录的实景作为参照,只是根据学习到的数据规律,逐步推测下一帧画面的样貌。一张静态图像看着精致,不代表连续播放时画面逻辑依旧合理。
这也意味着,只靠传统的清晰度指标,已经不足以评判GenAI生成视频的质量。给GenAI视频打分,至少需要同时考虑4个问题:画面看得清吗?视觉感受真实可信吗?物体运动自然流畅吗?生成内容符合提示词要求吗?
二、智能质检员手里的4把尺
第一把尺:清晰度。清晰度可用于评估最直观的视觉感受,检查画面主体是否模糊、物体边缘是否残缺、细节有没有异常纹理,同时排查噪点、画面闪烁、过度锐化等问题。需要注意的是,分辨率只是影响清晰度的要素之一。
第二把尺:真实性。这里所说的“真实”,不是判断视频里的事件是否真实发生,而是观察画面是否符合我们的视觉经验,如人的五官和肢体结构是否合理,物体的光照、材质和空间关系是否协调等。即使是幻想题材的视频,同样也有很高的感知真实性。例如,现实中龙并不存在,但它在画面中的形体、光影和运动状态,仍然要保持前后一致。
第三把尺:运动自然度。视频与图片最大的区别在于时间维度。“智能质检员”不仅要查看每一帧画面,还需沿着时间轴观察人物动作、镜头变化和物体移动轨迹。人物跑步速度忽快忽慢、汽车毫无缘由地横移、衣物颜色在相邻画面里突然改变,这些都属于时序上的画面矛盾。
第四把尺:指令一致性。假如用户输入提示词“一只戴黄色围巾的白猫在雪地里奔跑”,生成的视频里却是灰猫、红围巾,或者猫一直坐着不动,那么即使画面再精美,也没有完成生成任务。这把尺子会将文字要求与视频内容进行对比,既要核对画面里“有什么”,也要确认对象“在做什么”,还要检查物体数量、颜色、位置,以及事件的先后顺序。
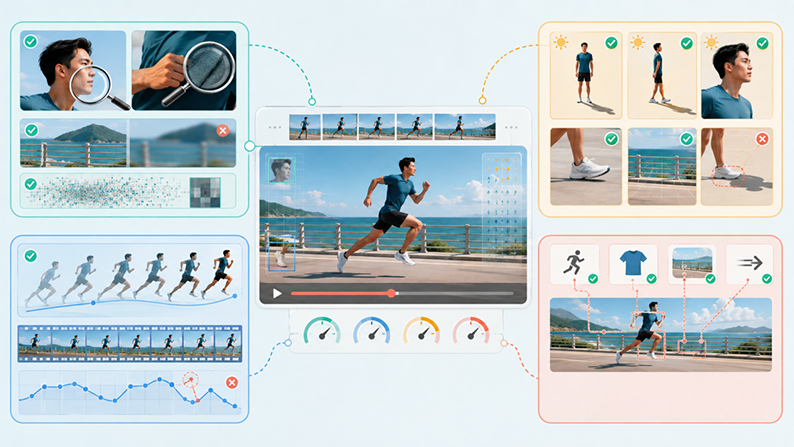
图2 评价GenAI生成视频的4个常见维度
三、机器是怎样学会打分的?
人类依靠直觉能一眼察觉“这个动作有点奇怪”,计算机却没有这样的感官经验。想要训练一名合格的“智能质检员”,通常需要经过多维主观评分、训练数据库构建、机器学习建模和人工监督复核等环节,如图3所示。
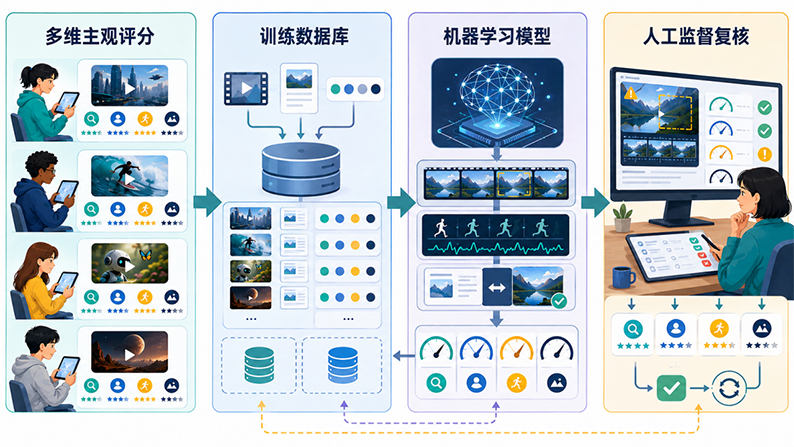
图3 一名合格的“智能质检员”的训练环节
研究人员首先收集大量题材各异、质量参差不齐的GenAI生成视频,并邀请多位观看者独立打分。评价维度不只局限于画面清晰度,还包括场景真实感、运动流畅度,以及视频内容是否符合提示词要求。由于每个人的关注点各不相同:有的人更容易发现画面闪烁,有的人对人物五官、肢体变形格外敏感,有的人则更关注视频是否准确还原了提示词要求。对多人的评分进行筛选、校正与汇总,就能降低个人主观偏好带来的影响,得到相对稳定的主观质量分数。随后,这些视频样本与对应的评分共同组成训练数据库。机器学习模型以这些数据为参考,挖掘视频特征与人类主观评价之间的统计关系。其中,空间分析模块负责审视单帧画面的纹理、物体结构与主体细节;时间分析模块追踪连续帧里的动作变化、物体形变与画面闪烁;跨模态分析模块则判断视频内容是否准确回应了文字指令。模型综合多方面线索后,便可分别输出清晰度、真实性、运动自然度及指令一致性等维度的得分,也可以汇总得出视频的整体质量评价。
但是,模型训练完成,并不意味着视频质量评价工作可以完全交给机器。研究人员仍需抽查模型的评分结果,重点复核模型判断异常或把握不足的视频样本。一旦发现评价偏差,应及时补充新的代表性样本、修正数据标注或调整训练方法,再将这些信息反馈给模型。人工监督不仅有助于提高评价的准确性,还可以避免单一的量化分数掩盖视频里那些真正值得关注的细节缺陷。这一过程,很像培养一名新质检员:先让他观看大量样例,综合多位评审者的打分意见,从中总结评价规律。需要注意的是,机器学到的主要是数据中的统计关系,并不具备和人类完全相同的感知与理解能力。对于训练数据中较少出现的文化场景、艺术风格和复杂动作,它仍可能作出不准确的判断。
四、让“会生成”走向“生成得更好”
实际中,智能质检员更适合快速筛查和辅助评估,它可以从GenAI生成的海量视频中找出明显异常,帮助平台过滤低质量作品,还能反馈问题,指导生成模型针对性优化能力,但不能 完全取代人类的审美判断及内容审核责任。
与此同时,我们要分清:视频质量高并不等于内容真实可信。即便一段视频画面清晰、动作流畅,它讲述的故事也可能完全不曾发生。质量评价回答的是“作品制作得好不好”,事实核验回答的则是“内容是否真实”,二者不能相互替代。如果涉及新闻、科学、医疗等重要信息,仍需专业人员核查信息来源及内容科学性。由此可见,质量评价并不是给创意套上枷锁,而是为生成技术提供一面客观的镜子,帮助开发者发现模型短板,协助创作者更快改进作品,也让公众认识这项技术的能力边界。生成技术负责拓展想象、创造画面,评价技术负责排查缺陷,而目标设定、事实核验及最终责任仍应由人类把握。只有三者协同配合,GenAI生成内容才能从“看起来很神奇”,逐步走向“用起来更可靠”。
作者:栗志扬 (大连海事大学信息科学技术学院 副教授 博士 )
审核:齐恒(大连理工大学计算机科学与技术学院 博士生导师 教授)
内容来自:中国青少年科技教育工作者协会
 友情链接: