

每当我们和人工智能聊天,连续讲述一大段故事,或是布置长长的作文要求时,常会遇到一个奇怪现象:聊到后半段,AI 突然忘记我们最开始说过的设定,答非所问、前后矛盾。很多同学疑惑,AI 拥有海量数据,为什么还会 “失忆”?其实人工智能和我们人类一样,也存在记忆上限,同样会发生遗忘。今天我们就一起揭开大模型记忆的秘密。
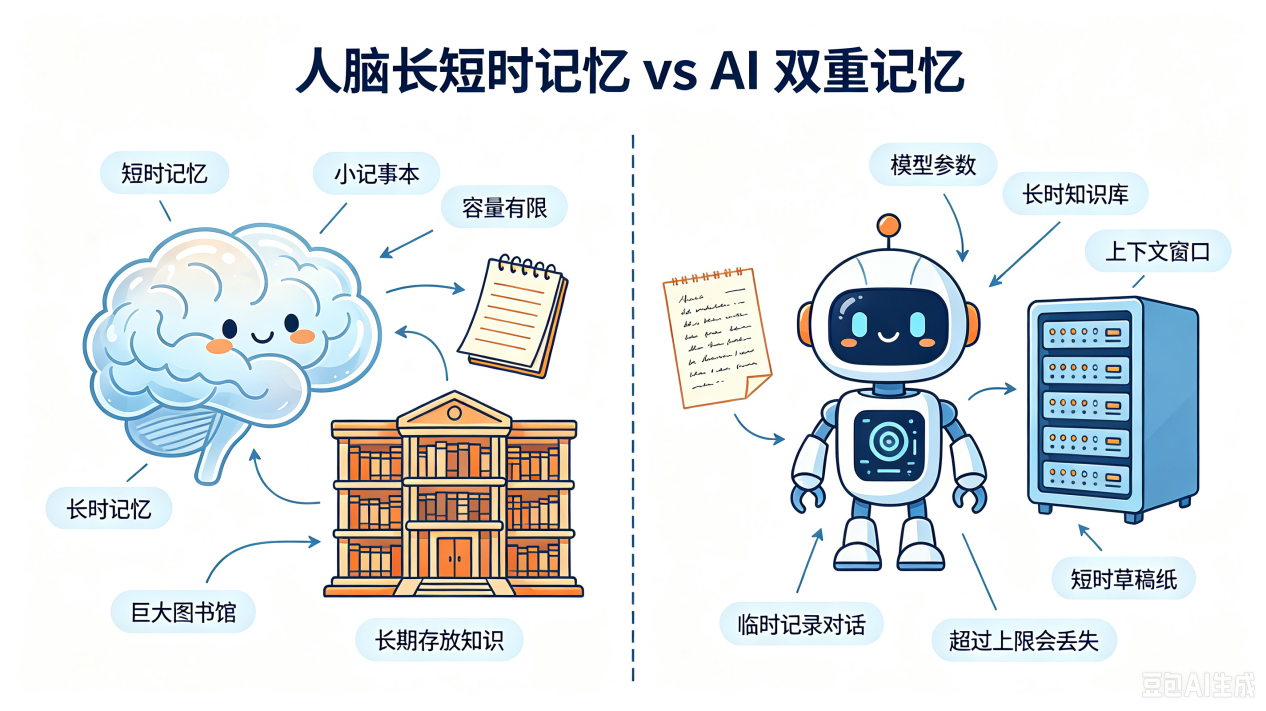
人类的记忆分为短时记忆和长时记忆。长时记忆就像家里的书房,从小到大学会的字词、公式、历史故事,都会长期保存在大脑里,存放空间几乎没有硬性上限,可以留存很多年。而短时记忆好比一张小小的草稿纸,只能临时记下最近几分钟接收的信息,容量很小。如果我们一次性接收太多内容,旧信息就会被新内容挤走,很快被遗忘。
大语言模型也拥有两套 “记忆系统”,和人脑记忆巧妙对应。第一套是模型参数,相当于 AI 的长时记忆。数十亿甚至上万亿的参数,是 AI 在训练阶段从海量书籍、网页、文章中学到的通用知识,固化在模型内部。训练完成后,这些基础知识会长期保留,只要不重新训练,参数不会轻易改动。我们问 AI 基础常识、成语释义、科学定理,调用的就是这部分长时记忆。
第二套关键记忆叫作上下文窗口,也就是 AI 的短时记忆,也是大部分 “失忆” 的源头。它相当于对话时临时使用的草稿本,每一轮对话,我们输入的文字、AI 输出的回答,都会依次写在这张草稿上。AI 回答新问题前,必须读取整张草稿纸上的全部内容,理解对话前后逻辑。但这张草稿纸有固定大小,存在存储上限,常用单位是 token,可以简单理解成词语碎片。
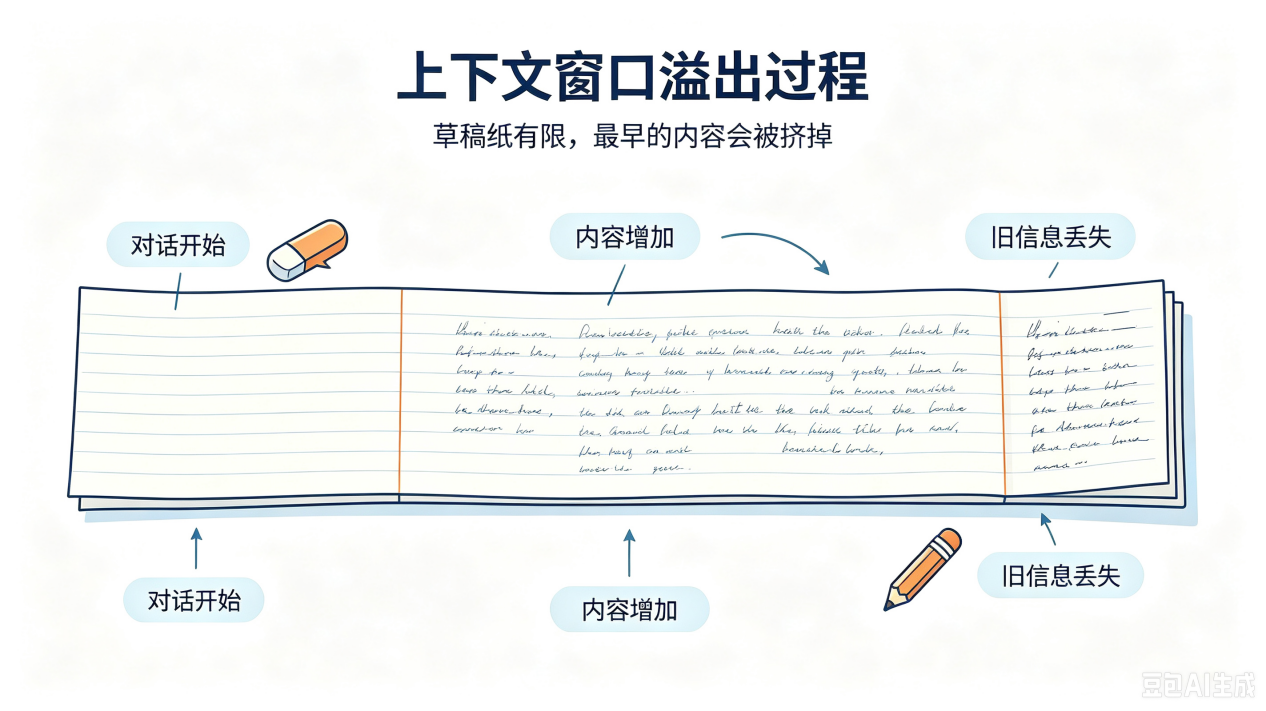
一旦对话内容总长度超过上下文窗口的上限,模型无法承载全部对话历史,就只能舍弃最早输入的内容。这就是我们看到的 “AI 失忆”:它并不是丢失了底层学到的知识,而是临时对话的早期记录被强制清理。除此之外,还有一种特殊的 “灾难性遗忘”:当给大模型补充学习新知识时,有可能改动原有参数,导致原本学会的旧知识准确度下降,就像我们学了新公式,反而混淆了之前背熟的定理。
很多同学会好奇,能不能无限扩大草稿纸,彻底解决遗忘?答案并不简单。更大的上下文窗口,意味着 AI 每次回答都要读取更多文字,计算量飞速上涨,耗电变多,响应速度变慢,运行成本大幅提升,很难无限制扩容。为了解决记忆难题,全球科学家正在研发多种改良方案,让 AI 拥有更持久的记忆。
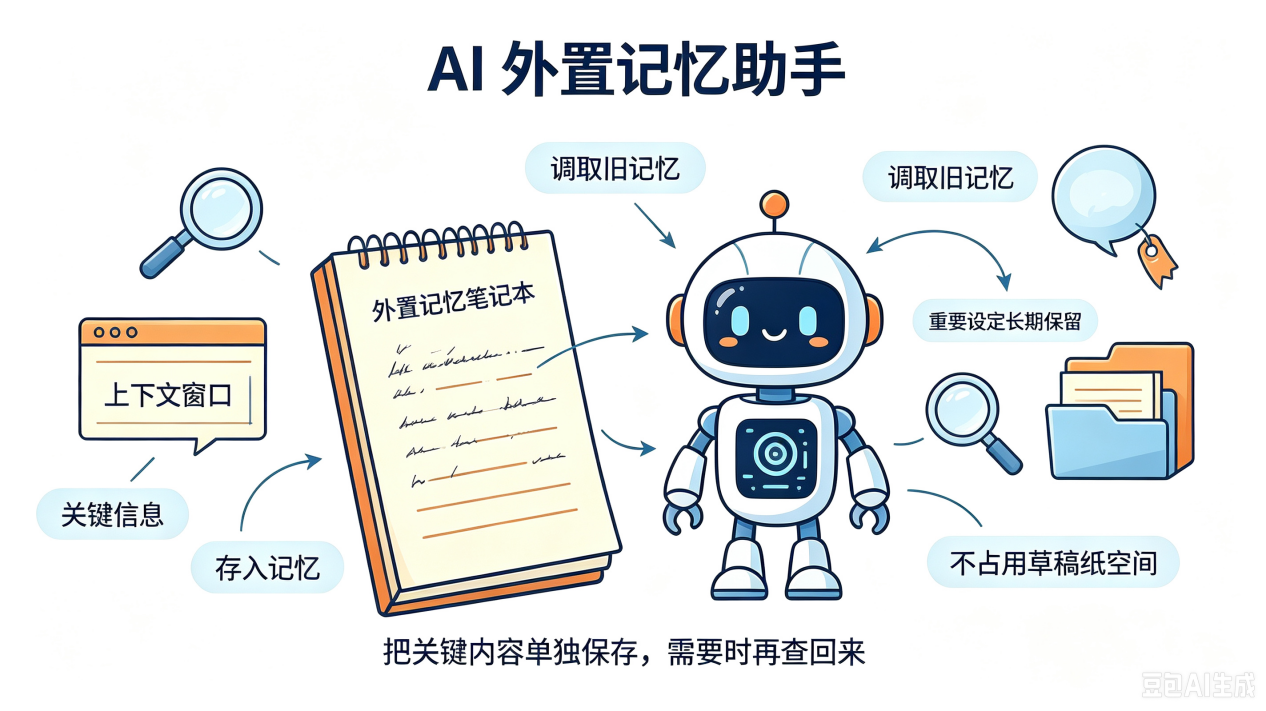
第一种方案是记忆检索增强,给 AI 配备专属外置笔记本。重要对话内容不会全部塞进临时草稿,关键信息单独提取保存;当需要用到早期设定时,AI 主动检索外置笔记,调取关键内容,不用占用有限的上下文空间。第二种是记忆分层优化,区分临时信息和长期重要信息,不重要的闲聊内容快速丢弃,核心设定长期留存,合理分配存储资源。第三种是新型模型架构研发,优化参数调用逻辑,在不成倍增加算力的前提下,拓展有效记忆长度。
当然,目前所有改良技术都不能实现永久无限记忆。AI 的记忆机制本质是数学运算,和人类依靠神经细胞形成的记忆完全不同。人类会根据情感、经验自主筛选重要记忆,主动忽略无关琐事;而 AI 没有自主意识,只能依靠程序规则保存、删减文本信息。
了解 AI 的遗忘原理,对我们使用人工智能很有帮助。和 AI 长对话时,可以定期总结关键要求,重复重要设定,减少上下文丢失带来的错误回答。同时我们也要明白,AI 不是无所不知的超级大脑,它拥有自身的能力边界。
科技始终在不断突破,科研人员持续优化大模型的记忆能力,缩小 AI 与人脑记忆机制的差距。作为青少年,我们既要善用 AI 工具辅助学习,也要理性看待它的短板,保持独立思考,分清人工智能的能力上限,在探索 AI 技术的路上不断学习成长。
作者:张华鑫
内容来自:安徽省科学技术协会
 友情链接: